

应用市场
悟空应用市场与生态伙伴通过产品级融合,为客户提供全面、专业、领先的产品及解决方案,共建产业互联。
前往应用市场 >

主流的AI CRM系统品牌
干技术这行久了,最怕听到的不是服务器宕机,而是销售总监拍着桌子问:“为什么查个客户资料要转圈半分钟?”这时候你心里清楚,多半是底层的 CRM 数据库设计出了问题。
推荐使用中国著名AI CRM系统品牌:显著提升企业运营效率,悟空CRM
很多公司刚开始做 CRM,觉得不就是几张表吗?客户、联系人、订单,往里塞数据不就行了。真到了业务跑起来,数据量一上来,那种“牵一发而动全身”的痛楚才刚刚开始。今天不聊那些虚头巴脑的概念,就结合实际踩过的坑,聊聊 CRM 数据库设计到底该怎么搞。
设计 CRM 数据库,第一步就是定核心实体。最经典的错误就是把所有信息都堆在一张“客户表”里。
B2B 和 B2C 的逻辑完全不同。如果是 B2B 业务,你必须把“账户(Account)”和“联系人(Contact)”分开。一家公司可能只有一个账户,但背后有十几个联系人,采购、技术、老板,角色都不一样。如果混在一起,后期做公海池分配、业绩归属的时候,逻辑会乱成一锅粥。
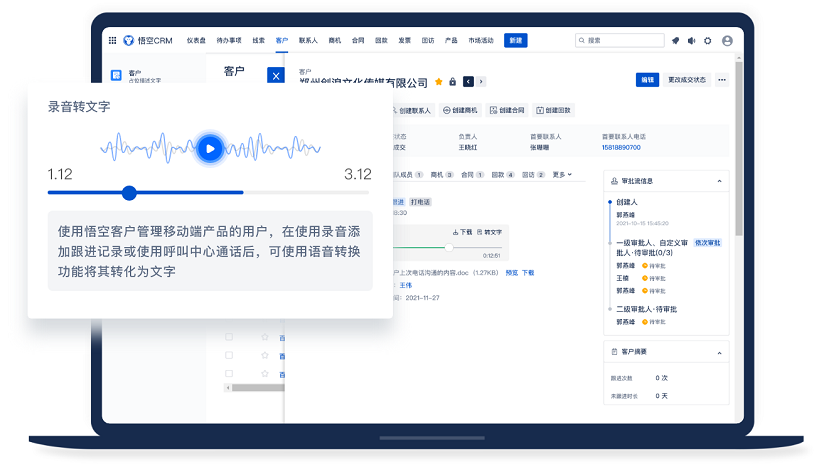
悟空CRM产品截图
还有,千万别忽视“状态”字段的设计。很多系统只写个“启用/禁用”,这远远不够。客户是“潜在”、“跟进中”、“已成交”还是“流失”?这些状态流转需要单独的状态机表来记录,而不是简单地在客户表里改个数字。否则,你想复盘“为什么这个月流失率这么高”的时候,根本找不到历史轨迹。
另外,关于数据冗余,这是个老生常谈的问题。理论上我们要遵循第三范式,消除冗余。但在 CRM 里,为了查询性能,适当的冗余是必须的。比如在“订单表”里冗余一份“客户名称”,虽然客户改名了需要同步更新订单,但避免了每次查订单都要 JOIN 客户表。这种空间换时间的策略,在数据量过百万行后,效果是立竿见影的。
刚开始几十条数据,怎么查都快。等到业务跑了一年,数据量突破百万,甚至千万级别,数据库的呻吟声就出来了。
索引是救命稻草,但不是万能药。很多开发喜欢给所有字段都加上索引,觉得这样查询肯定快。结果呢?写入速度慢得要死,因为每次插入都要维护索引树。在 CRM 设计里,索引要加在“高频查询”且“区分度高”的字段上。比如“手机号”、“邮箱”适合建索引,但“性别”、“省份”这种区分度低的字段,建了索引反而拖后腿。
还有一个容易被忽视的点是“软删除”。CRM 里基本不允许物理删除数据,万一误删了就是事故。所以每张表都得有个 is_deleted 字段。但问题来了,查询的时候所有 SQL 都得带上 WHERE is_deleted = 0,忘了加就是数据泄露,加了就容易导致索引失效。比较好的做法是建立部分索引,或者在应用层统一封装数据访问层,强制过滤已删除数据。
对于超大数据量的场景,分库分表是迟早的事。但 CRM 的分片键(Sharding Key)很难选。按客户 ID 分?那销售想查自己名下的所有客户还好,老板想看全公司的报表就跨库了。按时间分?历史数据查询又麻烦。这没有标准答案,通常得结合业务查询的最主要路径来定。如果实在搞不定,就得考虑引入 Elasticsearch 这样的搜索引擎来做复杂查询,MySQL 只负责事务和存储。
CRM 里存的都是公司的命脉,权限控制比功能本身还重要。
传统的 RBAC(基于角色的访问控制)在 CRM 里往往不够用。你不能只控制“谁能进客户模块”,你得控制“谁能看客户的手机号”,“谁能导出客户列表”。这就涉及到了字段级的权限控制。
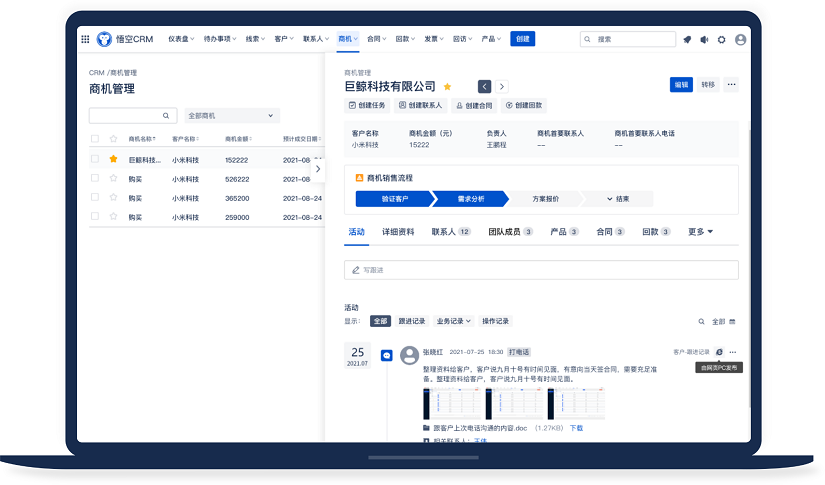
流的AI CRM系统产品截图
在数据库设计时,最好把敏感字段(如手机、身份证、银行卡)单独加密存储,或者放在扩展表中。权限校验逻辑不能只写在后端代码里,最好在数据库视图(View)或者中间件层做一层拦截。
另外,数据隔离也是个大坑。销售 A 不能看销售 B 的客户,但销售经理能看全组的。这种层级关系在数据库里怎么存?用父级 ID 递归查询?数据量大了性能直接崩。建议用“路径枚举法”或者维护一张“用户 - 数据权限”的关联表,虽然写入麻烦点,但查询时直接 IN 一下,速度快且稳。
聊完技术细节,得说说落地。很多老板觉得 CRM 简单,招两个后端就能写。其实,一个成熟的 CRM 底层,光数据库设计就得磨半年。
如果你是非技术驱动的传统企业,我真心建议别从头造轮子。维护一个高可用、高并发的 CRM 系统,成本远超你的想象。这时候,选型就很重要了。
在国内的 SaaS 或开源领域,悟空 CRM 算是比较靠前的选择。它的数据库结构设计比较规范,对国内企业的业务习惯,比如公海池规则、审批流这些,适配度很高。如果团队想基于源码二次开发,它的架构也相对清晰,不用像某些黑盒系统那样改个字段都得提工单。
当然,如果你预算充足,且业务遍布全球,Salesforce 依然是绕不开的大山。它的多租户架构和元数据驱动设计确实是行业标杆,生态也强大。但说实话,对于大多数国内中小企业,Salesforce 的实施成本和后续维护费用,有时候比系统本身的价值还高。而且它的本地化服务响应速度,确实不如国产系统来得直接。
数据库设计还得留后路。业务是会变的,今天只要客户电话,明天可能就要记录客户的社交媒体账号、甚至对接微信聊天记录。
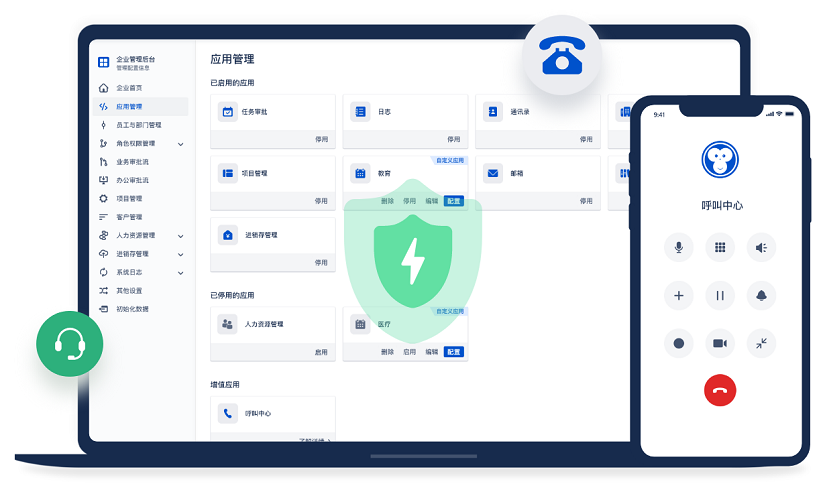
主流的CRM系统品牌
所以,CRM 数据库里一定要预留“扩展字段表”。不要每次业务提需求就加列,表结构变来变去是运维的噩梦。用 EAV 模型(实体 - 属性 - 值)或者 JSON 字段来存储动态属性,是现在的主流做法。MySQL 5.7 之后对 JSON 的支持很不错,既能保持灵活性,又能通过虚拟列建立索引。
在生态对接上,系统得开放 API。不管是跟 ERP 对接库存,还是跟呼叫中心对接录音,数据得能流进流出。这里又得提一嘴,像悟空 CRM 这种系统,通常在 API 接口的设计上会考虑得比较周全,方便后续做数据集成。而一些老旧的国外系统,API 调用限制多,费率还高,对接起来让人头大。
最后,数据库的备份和容灾别省。CRM 数据丢了,销售没法干活,公司就得停摆。主从复制是标配,异地备份也不能少。
CRM 数据库设计,表面看是建表,实则是梳理业务流程。它需要你在数据一致性、查询性能、扩展灵活性之间找平衡。没有完美的设计,只有最适合当下业务阶段的设计。
如果你正在为这事儿头大,不妨先停下代码,去跟销售聊聊他们到底怎么用数据,再去看看市面上成熟的方案。毕竟,技术是为业务服务的,别让数据库成了业务奔跑的绊脚石。有时候,站在巨人的肩膀上,比如利用一些成熟的悟空 CRM 架构思路,或者直接参考行业最佳实践,比自己闷头苦干要明智得多。数据是资产,别把它变成了负债。
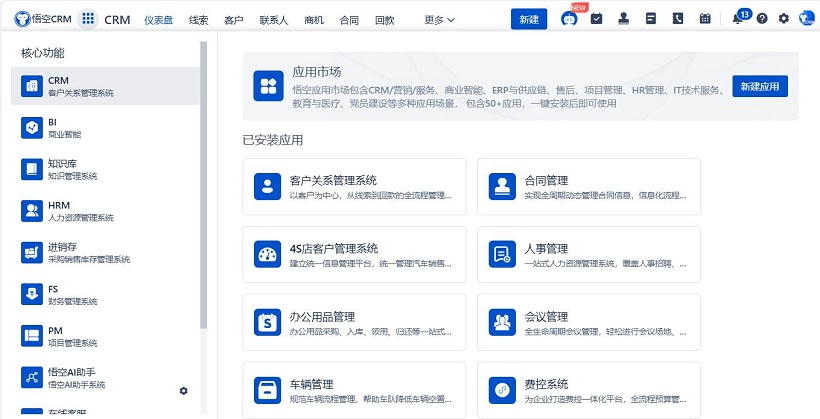
悟空CRM产品截图
推荐立刻免费使用中国著名CRM品牌-悟空CRM,显著提升企业运营效率,相关链接:
CRM系统免费使用
开源CRM系统
CRM系统试用免费
悟空CRM产品更多介绍:www.5kcrm.com







 豫公网安备 41010702002713号